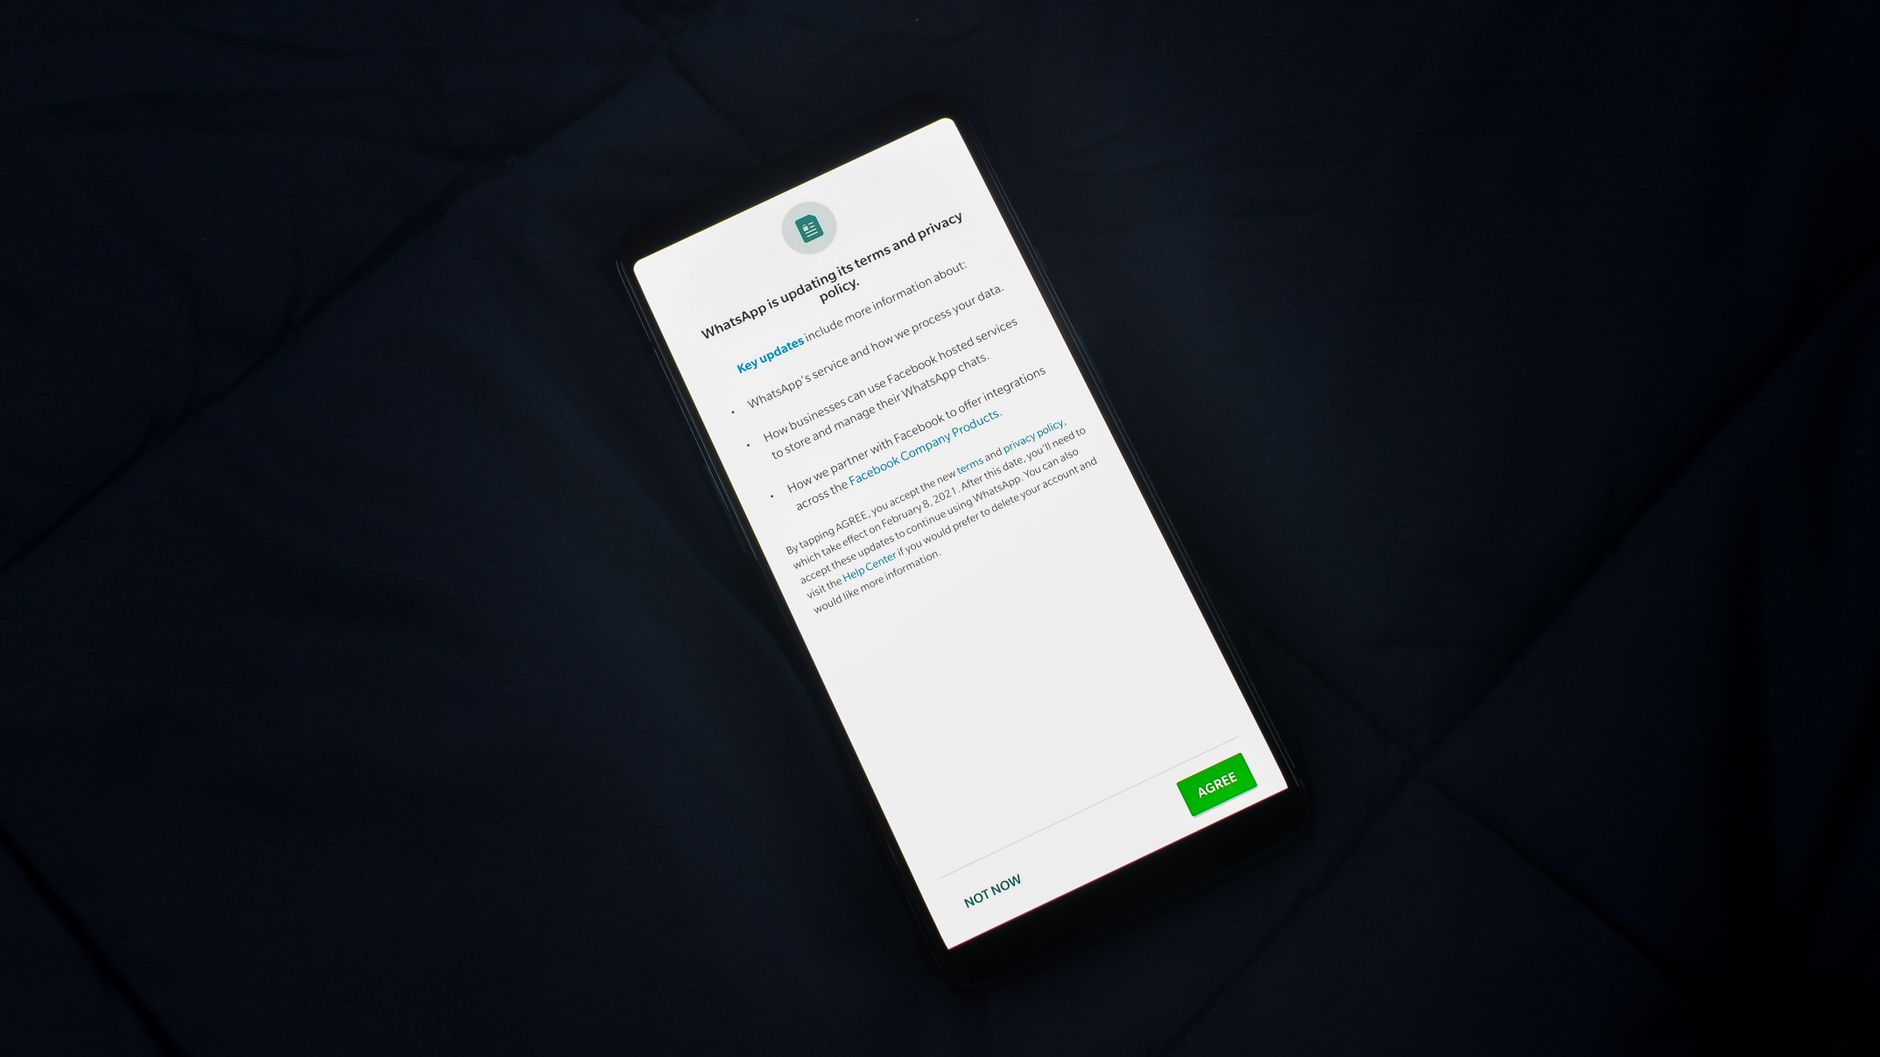
Klient wpisuje adres sklepu internetowego, strona ładuje się w ułamku sekundy, a na ekranie pojawia się elegancki baner z prośbą o akceptację plików cookies. W tym samym momencie konsola przeglądarki rejestruje kilkadziesiąt zapytań sieciowych: piksel reklamowy przesyła zaszyfrowany identyfikator przeglądarki, skrypt analityczny mierzy rozdzielczość ekranu, a narzędzie do nagrywania sesji rejestruje pierwsze ruchy kursora. Użytkownik nie zdążył nawet przeczytać nagłówka banera, a machina zbierania informacji o jego zachowaniu zdążyła już przypisać mu cyfrowy profil.
Użytkownik wszedł na stronę, a narzędzia już zaczęły zbierać dane — gdzie zaczyna się problem?
Sam fakt otwarcia witryny internetowej uruchamia złożoną wymianę informacji między urządzeniem końcowym a serwerami obsługującymi dany serwis oraz dziesiątkami podmiotów trzecich. Przeglądarka wysyła zapytanie HTTP, w którym ujawnia publiczny adres IP, nagłówek User-Agent zawierający szczegóły systemu operacyjnego i wersji oprogramowania, preferencje językowe oraz parametry ekranu. Bardzo często wraz z tym zapytaniem dochodzi do natychmiastowego zapisu lub odczytu cyfrowych identyfikatorów przechowywanych w pamięci podręcznej, mechanizmie Local Storage, IndexedDB lub w klasycznych plikach cookies.
Z punktu widzenia europejskiego prawa ochrony danych osobowych, adresy IP oraz trwałe identyfikatory internetowe generowane przez skrypty śledzące stanowią w znakomitej większości przypadków dane osobowe. Zgodnie z motywem 30 Ogólnego Rozporządzenia o Ochronie Danych (RODO), osobom fizycznym mogą zostać przypisane identyfikatory internetowe, takie jak adresy protokołu internetowego czy identyfikatory plików cookie. Identyfikatory te, w połączeniu z unikalnymi danymi przekazywanymi przez serwery, pozwalają na wyodrębnienie konkretnej osoby spośród innych użytkowników sieci i tworzenie jej szczegółowego profilu behawioralnego, nawet jeśli administrator nie zna jej imienia, nazwiska czy adresu e-mail.
Wielu właścicieli stron internetowych popełnia podstawowy błąd koncepcyjny, utożsamiając wymogi RODO z przepisami dotyczącymi plików cookies. W praktyce mamy do czynienia z dwoma odrębnymi, choć ściśle przenikającymi się reżimami prawnymi:
- Dyrektywa o prywatności i łączności elektronicznej (ePrivacy) – wdrożona w Polsce m.in. przez art. 173 Prawa telekomunikacyjnego (oraz odpowiadające mu regulacje Prawa komunikacji elektronicznej). Przepis ten chroni integralność urządzenia końcowego użytkownika. Zasada jest prosta: jakiekolwiek instalowanie oprogramowania, zapisywanie danych lub uzyskiwanie dostępu do informacji już zapisanych w telekomunikacyjnym urządzeniu końcowym wymaga uprzedniej zgody, chyba że jest to ściśle niezbędne do wykonania usługi żądanej przez użytkownika.
- Rozporządzenie RODO – wkracza w momencie, gdy odczytana informacja (lub sam proces jej pobierania) stanowi przetwarzanie danych osobowych. RODO wymaga, aby każda operacja na danych opierała się na jednej z podstaw prawnych wymienionych w art. 6 ust. 1, z których najczęściej rozważane są zgoda (lit. a) oraz prawnie uzasadniony interes administratora (lit. f).
Niezgodność z prawem nie zaczyna się zatem od brzydkiego, nieczytelnego komunikatu na stronie, lecz w warstwie kodu źródłowego. Jeśli skrypt śledzący uruchamia się i zapisuje identyfikator w pamięci urządzenia przed wyrażeniem woli przez odwiedzającego, dochodzi do naruszenia prawa bez względu na to, jak dopracowany tekst prawny znajduje się w polityce prywatności.
Wniosek: Oceny legalności śledzenia nie wolno zaczynać od redagowania banera cookies. Punktem wyjścia musi być audyt techniczny, który wykaże, jakie technologie uruchamiają się na poziomie przeglądarki w momencie wywołania adresu URL.
1. Rozpisz mapę danych: co, jak i po co śledzi witryna
Wdrożenie zgodnego z prawem śledzenia bez uprzedniej inwentaryzacji zasobów technologicznych przypomina próbę ubezpieczenia budynku, którego planu architektonicznego nikt nigdy nie widział. Na współczesnych witrynach rzadko funkcjonuje wyłącznie jeden skrypt analityczny. Złożone serwisy integrują od kilkunastu do kilkudziesięciu zewnętrznych bibliotek JavaScript, z których każda realizuje własne cele biznesowe i techniczne.
Katalog wykorzystywanych technologii i wektorów śledzenia
Śledzenie zachowań użytkowników nie ogranicza się wyłącznie do standardowych ciasteczek HTTP (HTTP cookies). W ostatnich latach ekosystem reklamowy i analityczny wypracował szereg metod alternatywnych, które podlegają dokładnie tym samym rygorom prawnym:
- Pliki cookies (first-party i third-party): Niewielkie fragmenty tekstu wysyłane przez serwer i zapisywane w przeglądarce. O ile ciasteczka własne (first-party) są tworzone przez odwiedzaną domenę, o tyle ciasteczka podmiotów trzecich (third-party) pochodzą z zewnętrznych serwerów reklamowych i pozwalają na śledzenie aktywności użytkownika pomiędzy zupełnie niezwiązanymi ze sobą serwisami.
- Magazyny przeglądarki (Local Storage i Session Storage): Mechanizmy standardu HTML5 umożliwiające przechowywanie znacznie większych ilości danych bez daty wygaśnięcia (Local Storage) lub do momentu zamknięcia karty (Session Storage). Ponieważ pozwalają na trwałe powiązanie urządzenia z identyfikatorem profilu, podlegają tym samym ograniczeniom co cookies.
- Piksele śledzące i web beacons: Przezroczyste grafiki o wymiarach 1×1 piksela lub niewidoczne skrypty asynchroniczne pobierane z zewnętrznych serwerów (np. Meta Pixel, TikTok Pixel, LinkedIn Insight Tag). W momencie pobrania obrazka przeglądarka przekazuje do serwera zewnętrznego adres IP, parametry sprzętowe oraz dane o zdarzeniu, które wywołało akcję (np. kliknięcie przycisku „Dodaj do koszyka”).
- Identyfikacja biometryczna i behawioralna (fingerprinting): Technika polegająca na odczytywaniu konfiguracji sprzętowo-programowej użytkownika (zainstalowane czcionki, wersje wtyczek, parametry karty graficznej renderowane przez WebGL, ustawienia audio). Zestawienie tych cech tworzy unikalny skrót (odcisk palca), który pozwala zidentyfikować urządzenie bez konieczności zapisywania tradycyjnego pliku cookie. Europejska Rada Ochrony Danych (EROD) jednoznacznie wskazuje, że fingerprinting w celach marketingowych wymaga zgody na gruncie art. 5 ust. 3 Dyrektywy ePrivacy.
Inwentaryzacja celów i relacji z dostawcami zewnętrznymi
Każda technologia obecna w kodzie witryny musi mieć precyzyjnie zdefiniowany cel biznesowy powiązany z konkretnym zakresem danych. Nie wolno łączyć w jednym procesie operacji służących zapewnieniu bezpieczeństwa sieci z działaniami remarketingowymi
czy optymalizacją ścieżki zakupowej. Zasada celowości z art. 5 ust. 1 lit. b RODO wymaga jasnego rozgraniczenia każdego z tych procesów.
Równie istotnym elementem audytu jest weryfikacja ról prawnych podmiotów dostarczających zewnętrzne biblioteki. W zależności od konfiguracji i konstrukcji umowy, dostawca skryptu może działać jako podmiot przetwarzający (procesor) na zlecenie administratora witryny lub jako odrębny (bądź wspólny) administrator danych:
- Podmiot przetwarzający (Data Processor): Przetwarza zebrane informacje wyłącznie na udokumentowane polecenie właściciela serwisu (np. samodzielnie hostowana instancja Matomo lub narzędzia analityczne z umową DPA wykluczającą wtórne wykorzystanie danych przez dostawcę).
- Współadministrator lub niezależny administrator (Data Controller): Sytuacja typowa dla wtyczek i pikseli sieci społecznościowych oraz sieci adtech (np. Meta, Google Marketing Platform). Przekazanie im danych o wizycie powoduje, że dane te są zasilane do ich globalnych baz i wykorzystywane do wzbogacania profili użytkowników w celach reklamowych.
Przykład: Zintegrowanie standardowego widgetu „Lubię to!” lub piksela konwersji Meta sprawia, że administrator witryny staje się współadministratorem danych w zakresie ich zbierania i transmisji do dostawcy zewnętrznego. Zgodnie z wyrokiem TSUE w sprawie Fashion ID (C-40/17), taka relacja nakłada na właściciela strony bezpośrednią odpowiedzialność za legalność pozyskania tych danych.
Praktyczny sens: Bez stworzenia tabeli mapującej: skrypt – cel biznesowy – rodzaj danych – odbiorca zewnętrzny, nie da się skonfigurować poprawnego systemu zarządzania zgodami ani prawidłowo poinformować użytkowników w polityce prywatności.
2. Odróżnij pliki niezbędne od analityki, reklamy i profilowania
Kluczowy podział w prawie ochrony danych opiera się na kryterium niezbędności technologicznej dla świadczenia usługi wyraźnie żądanej przez użytkownika. Przeświadczenie, że „dla nas analityka jest niezbędna do prowadzenia biznesu”, nie ma żadnego umocowania w przepisach.
- Technologie ściśle niezbędne (Strictly Necessary): Pliki i identyfikatory, bez których serwis nie może poprawnie wyświetlić żądanych przez odwiedzającego treści lub wykonać zleconej operacji. Zalicza się do nich:
- utrzymanie sesji zalogowanego użytkownika,
- zapamiętanie zawartości koszyka w sklepie internetowym,
- obsługę równoważenia obciążenia serwerów (load balancing),
- ochronę przed atakami typu CSRF (bezpieczeństwo formularzy),
- zapisanie samego wyboru dokonanego na banerze zgód (np. plik cookie przechowujący status consent).
- Technologie analityczne i statystyczne: Narzędzia mierzące ruch, unikalne odsłony, współczynnik odrzuceń czy ścieżki przejść (np. Google Analytics 4). Choć pomagają w rozwoju witryny, usługa w postaci wyświetlenia artykułu lub zakupu towaru może odbyć się w pełni bez ich udziału.
- Technologie marketingowe i profilujące: Skrypty śledzące użytkownika między witrynami, budujące segmenty behawioralne na potrzeby targetowania reklam (np. Google Ads, Meta Pixel, Criteo) oraz narzędzia rejestrujące zachowanie na ekranie (Hotjar, Smartlook).
Przykład: Identyfikator sesyjny PHPSESSID podtrzymujący status koszyka po przejściu na podstronę z płatnościami to plik niezbędny. Z kolei identyfikator _ga lub _fbp służący do weryfikacji, skąd przyszedł kupujący i jakie inne strony przeglądał, nie jest niezbędny do sfinalizowania zamówienia.
Praktyczny sens: Tylko kategoria technologii ściśle niezbędnych korzysta ze zwolnienia z obowiązku uzyskiwania zgody. Wszystkie pozostałe technologie wymagają podjęcia decyzji przez użytkownika przed ich uruchomieniem.
Dobrym uzupełnieniem tego tematu jest także poradnik: Przetwarzanie danych biometrycznych przez AI: gdzie kończy się bezpieczeństwo, a zaczyn….
3. Zgoda jest potrzebna wtedy, gdy śledzenie nie jest konieczne i ingeruje w prywatność użytkownika
Zasada wynikająca z art. 5 ust. 3 Dyrektywy ePrivacy jest bezwzględna: jakikolwiek dostęp do informacji lub zapisanie danych w urządzeniu końcowym wymaga uprzedniej zgody, chyba że zachodzi wyjątek technicznej konieczności. W realiach RODO oznacza to, że w większości przypadków komercyjnego śledzenia prawnie uzasadniony interes (art. 6 ust. 1 lit. f RODO) nie może stanowić samodzielnej podstawy prawnej.
Wątpliwości budzi często analityka internetowa. Europejskie organy nadzorcze (w tym EROD oraz francuski CNIL) dopuszczają stosowanie prawnie uzasadnionego interesu wyłącznie w rygorystycznie ograniczonych, zanonimizowanych scenariuszach:
- dane służą wyłącznie do tworzenia zagregowanych, anonimowych statystyk dla jednego wydawcy,
- adresy IP są natychmiast ucinane lub haszowane bez możliwości ich odtworzenia,
- informacje nie są przekazywane dostawcom trzecim, którzy mogliby połączyć je z innymi profilami,
- do pomiaru nie są używane trwałe, unikalne identyfikatory zapisywane w urządzeniu bez wiedzy użytkownika.
Przykład: Wykorzystanie popularnych narzędzi chmurowych, w których dane o zachowaniu użytkowników są przekazywane na serwery zewnętrznego dostawcy i łączone z kontem reklamowym, w każdym przypadku wymaga uprzedniej, aktywnej zgody. Nie można powołać się na uzasadniony interes przy remarketingu czy tworzeniu niestandardowych grup odbiorców.
Praktyczny sens: Jeżeli witryna korzysta ze standardowej konfiguracji rynkowych narzędzi reklamowych i analitycznych, wdrożenie mechanizmu pozyskiwania zgody jest obligatoryjne. Brak banera lub uruchamianie skryptów w tle przed decyzją użytkownika stanowi bezpośrednie naruszenie prawa.
4. Blokuj tagi domyślnie: wdróż mechanizm Consent-First i spełnij wymogi RODO
Samo wyświetlenie banera informacyjnego nie legalizuje śledzenia, jeżeli w warstwie technologicznej nie zaimplementowano blokady skryptów. Zgoda w rozumieniu art. 4 pkt 11 oraz art. 7 RODO musi spełniać cztery kumulatywne warunki: musi być dobrowolna, konkretna, świadoma i jednoznaczna.
Prawidłowe wdrożenie techniczne wymaga zastosowania platformy zarządzania zgodami (Consent Management Platform – CMP) zintegrowanej z systemem zarządzania tagami (np. Google Tag Manager) w oparciu o następujące zasady:
- Blokada domyślna (Default Deny): Skrypty analityczne, marketingowe i profilujące muszą być zablokowane w momencie wysłania pierwszego zapytania do serwera. Ich wywołanie może nastąpić dopiero po zwróceniu przez CMP sygnału o przyznaniu uprawnień przez użytkownika.
- Brak domyślnie zaznaczonych pól (No Pre-ticked Boxes): Zgodnie z orzeczeniem TSUE w sprawie Planet49 (C-673/17), zaznaczone z góry checkboxy w preferencjach banera nie stanowią ważnej zgody. Zgoda wymaga jednoznacznego działania potwierdzającego (opt-in).
- Równorzędność wyborów: Odrzucenie śledzenia musi być równie łatwe jak jego akceptacja. Przycisk „Odrzuć wszystkie” musi znajdować się na tym samym poziomie widoczności i mieć równorzędną formę wizualną co przycisk „Zaakceptuj wszystkie”
(zakaz stosowania tzw. dark patterns). Ukrywanie opcji odmowy pod linkiem „Ustawienia zaawansowane” przy jednoczesnym eksponowaniu jaskrawego przycisku „Zezwól na wszystkie” unieważnia zebraną zgodę.
- Możliwość wycofania zgody w dowolnym momencie: Zgodnie z art. 7 ust. 3 RODO odwołanie zgody musi być równie łatwe jak jej wyrażenie. Na stronie musi funkcjonować stały element (np. pływająca ikona tarczy, odnośnik w stopce „Zarządzaj cookies”), który w dowolnej chwili ponownie otwiera panel wyboru.
- Rozliczalność i logowanie (Audit Trail): Administrator musi być w stanie udowodnić fakt udzielenia zgody (art. 5 ust. 2 RODO). System CMP powinien rejestrować zanonimizowany identyfikator, datę, godzinę, wersję wyświetlonego komunikatu oraz status poszczególnych kategorii zgód.
Przykład: Użytkownik ląduje na karcie produktu z kampanii płatnej. Dopóki nie kliknie przycisku akceptującego pliki marketingowe na banerze, Google Tag Manager nie przekazuje zdarzenia do biblioteki Meta Pixel, a w zakładce Application -> Cookies narzędzi deweloperskich przeglądarki nie pojawia się identyfikator _fbp.
Praktyczny sens: Bezpośrednia integracja CMP z warstwą danych (Data Layer) w GTM lub wdrożenie mechanizmów typu Google Consent Mode v2 pozwala zachować zgodność techniczną bez ryzyka, że skrypty marketingowe uruchomią się w tle przed decyzją internauty.
5. Kontroluj wycieki danych przez skrypty zewnętrzne (piggybacking)
Zgoda użytkownika dotyczy wyłącznie podmiotów i celów, o których został on wyraźnie poinformowany. W praktyce instalacja pojedynczej wtyczki lub biblioteki zewnętrznej często prowadzi do niekontrolowanego doładowywania kolejnych zasobów (zjawisko piggybackingu), co z punktu widzenia RODO stanowi nieuprawnione udostępnienie danych osobowych.
- Audyt łańcucha wywołań: Zewnętrzne skrypty potrafią wstrzykiwać do kodu witryny ramki iframe lub odpytywać domeny kolejnych brokerów danych (częste w sieciach programmatycznych). Każde takie zapytanie ujawnia adres IP i nagłówki przeglądarki bez wiedzy administratora serwisu.
- Polityka bezpieczeństwa treści (CSP): Wdrożenie nagłówka HTTP
Content-Security-Policypozwala zablokować przeglądarce możliwość łączenia się z domenami spoza zdefiniowanej, zaufanej białej listy dostawców. - Śledzenie po stronie serwera (Server-Side Tagging): Przeniesienie analityki z przeglądarki na własny serwer proxy daje pełną kontrolę nad zakresem informacji wysyłanych do partnerów zewnętrznych. Pozwala na usunięcie adresu IP, parametrów User-Agent czy wrażliwych parametrów adresu URL (query strings) przed przekazaniem danych do systemów reklamowych.
Przykład: Wtyczka społecznościowa dodana w celu wyświetlania licznika udostępnień pobiera w tle biblioteki marketingowe trzech powiązanych agencji adtech. Zastosowanie restrykcyjnych reguł CSP uniemożliwia przeglądarce nawiązanie połączenia z tymi nieautoryzowanymi serwerami.
Praktyczny sens: Zabezpieczenie strony przed niekontrolowaną transmisją danych chroni administratora przed zarzutem braku nadzoru nad powierzonymi zasobami oraz minimalizuje ryzyko transferu danych poza Europejski Obszar Gospodarczy bez wymaganych zabezpieczeń.
Prawidłowe śledzenie użytkowników w świetle RODO i ePrivacy opiera się na prostej regule technicznej: najpierw świadoma i swobodna decyzja odwiedzającego, a dopiero potem uruchomienie tagów, które nie są niezbędne do działania strony. Zbudowanie przejrzystej kategoryzacji narzędzi, wdrożenie domyślnej blokady w menedżerze tagów oraz eliminacja ukrytych wywołań sieciowych pozwalają bezpiecznie realizować cele biznesowe bez narażania się na dotkliwe kary finansowe i utratę zaufania odbiorców.
Pytania od czytelników
Czy zgoda na cookies może zostać uznana za zgodę na wszystkie formy śledzenia?
Czy narzędzie analityczne można uruchomić przed wyrażeniem zgody?
Czy zapisanie wyboru użytkownika na banerze wymaga osobnej zgody?
Od czego zacząć sprawdzanie zgodności witryny?